スタジオでの自己紹介
カメラに向かう自己紹介で、細かな表情の変化を確認します。
音声録音
提案プロンプト
画像1を、唯一の話し手の外見、衣服、背景の参照にしてください。アップロードした録音に合わせて、言葉、口の動き、無音の間を反映して話させてください。同じ顔を保ち、カメラを固定してください。 落ち着いた親しみやすい表情と、小さく自然な手の動きを使ってください。
ポートレートと録音した音声から、人物が話す短い動画を作成。音声参照に対応したモデルを選び、表情、構図、動画の長さを設定できます。
声を聞き、演技を確認しましょう。写真、録音、演技の指示を読み込み、自分のバージョンを試せます。
カメラに向かう自己紹介で、細かな表情の変化を確認します。
画像1を、唯一の話し手の外見、衣服、背景の参照にしてください。アップロードした録音に合わせて、言葉、口の動き、無音の間を反映して話させてください。同じ顔を保ち、カメラを固定してください。 落ち着いた親しみやすい表情と、小さく自然な手の動きを使ってください。
一人の顔と一つの録音を、演技の出発点に。
短い挨拶や自己紹介を、人物が話すポートレート動画にします。
聞き取りやすい解説に、見やすい顔と控えめな身振りを合わせます。
キャラクターやマスコットに、その個性に合う声を組み合わせます。
モデルを選び、顔が見える写真とMP3またはWAVの録音をアップロードします。
必要に応じて表情や身振りを指定。一文が収まる長さと画面比率を選びます。
クレジットを確認して生成し、声と口の動きを比較してからダウンロードします。
JPEG、PNG、WebPのポートレート1枚と、MP3またはWAVの音声1本を用意してください。一人の声が明瞭な録音を使い、選択モデルの制限に従ってください。
はい。録音した音声をアップロードしてください。モデルが声、言葉、演技の参照として使います。
写真と録音だけで送信できます。演技の指示は任意で、表情や身振りを調整できます。
音声と口の動きは生成され、結果はモデルや素材によって異なります。全体を音声付きで再生し、特に間と語尾を元の録音と比較してください。
選択モデルで利用できる長さを選べます。録音は動画の長さとモデルの音声制限の両方に収めてください。長い録音は文の区切りで分割します。
モデルと動画の長さに応じたクレジットが表示されます。作例の読み込みはフォームへの入力です。新しいテイクを作るときに生成を押してください。
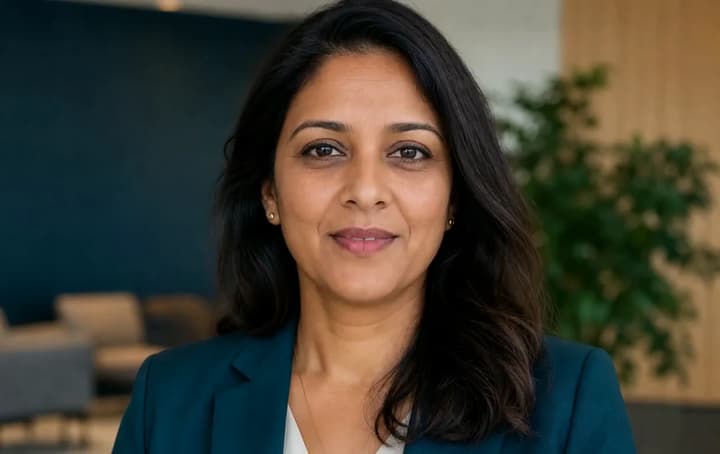
顔が見える写真と一文の音声を用意し、設定を選択。話し方、口の動き、人物の一貫性を確認してテイクを選びます。
音声クリップと参照画像から短いAI動画を作成。シーンを説明し、音声参照に対応したモデルを選んで生成できます。
参照動画の動きでキャラクター画像を動かします。モデルを選び、画像と動画を追加して短い演技を作成できます。

テキストで動画を編集。クリップをアップロードし、服装・物・背景・照明の変更を指定できます。必要に応じて参考画像で見た目を伝えましょう。

気に入ったカットに、もう少し続きを。動画をアップロードして次の動きを説明すると、元の映像をもとに続きのクリップを生成できます。