深海からの信号
30秒のデモ・16:9。静かな港が異変の舞台を示し、最後まで脅威の正体を残します。
無人の港の下から何かが聞こえる海辺の町。不安を積み重ね、一つの不穏な手がかりを見せます。
提案プロンプト
抑制の利いた海辺のミステリーティーザー。灰色の霧に包まれた無人の港をゆっくり空撮。水中から低い脈動を聞いて足を止める成人の港湾作業員へカット。最後は潮に逆らう波紋で終え、発生源は見せない。自然な人体、落ち着いた色、明確なカット、静かな風と低い水中音。台詞、タイトル、文字なし。
AIで予告編を作るには、観客に残す疑問を決め、少数の映像の展開を計画し、短いクリップを生成して良い部分を編集します。構成が成立してから、読みやすいタイトルと一貫した音を加えます。短いティーザーは1回で作れますが、長い予告編には素材の選別と編集が必要です。
LumiYing更新日
主人公、障害、未解決の疑問を一つずつ決めます。
例では、何年も運行していない列車から捜査官にメッセージが届きます。中で誰が待っているのか。列車の歴史や乗客の正体は明かしません。この判断によって、編集に必要な映像が決まります。
一文の設定、ジャンル、目標尺、公開先の画面を用意します。人物や場所をそろえるなら、光の条件が合う鮮明な参考画像を選びます。異なる衣装や複数の顔は、役割を説明せずに混ぜないでください。
クレジットを使う前に物語を整理し、編集に必要な素材だけを生成します。
人物、異変、疑問を一文にします。捜査官がメッセージを追って廃駅へ向かうと、すでに車両に明かりがある。この具体的な出来事は「壮大で映画的」だけの指定より役立ちます。
手がかり、緊張の高まり、未解決の最後の画を計画します。下の30秒プランは最終編集の目安であり、モデルが秒単位で守る保証ではありません。タイトルと間のための時間も確保します。
必要なら主人公と駅の画像を1枚ずつ使い、それぞれ何を定義するか説明します。その後に動作、カメラ、音を書きます。短いショットに複数の場所、多数の動作、長い台詞を詰め込まないでください。
Promptに入力し、任意で最大6枚の画像を追加。モデル、長さ、横型16:9または縦型9:16を選びます。最初は10秒で展開を絞って試し、料金を確認します。プロンプトの読み込みだけでは生成されません。
使えるテイクを編集ソフトへ読み込みます。不要な前置きを切り、動作や音をきっかけにカットし、情報の重複を削ります。例では3本のクリップをプランに合わせて調整します。タイトルは編集可能な文字レイヤーにし、表記と表示時間を管理します。
別々に生成した音楽はカットで不自然に切り替わることがあります。使える環境音を残し、台詞の下では音量を下げ、必要なら許諾済みの曲を一つ通します。無音と音ありで確認し、同じ比率で書き出してスマートフォンでもファイルを見ます。
時間は完成後の編集を示します。可能なら少し長い素材を作ると、自然な開始点と終了点を選べます。
この練習例を使って10秒のティーザーを作ります。設定を維持し、問題点を一つずつ直します。
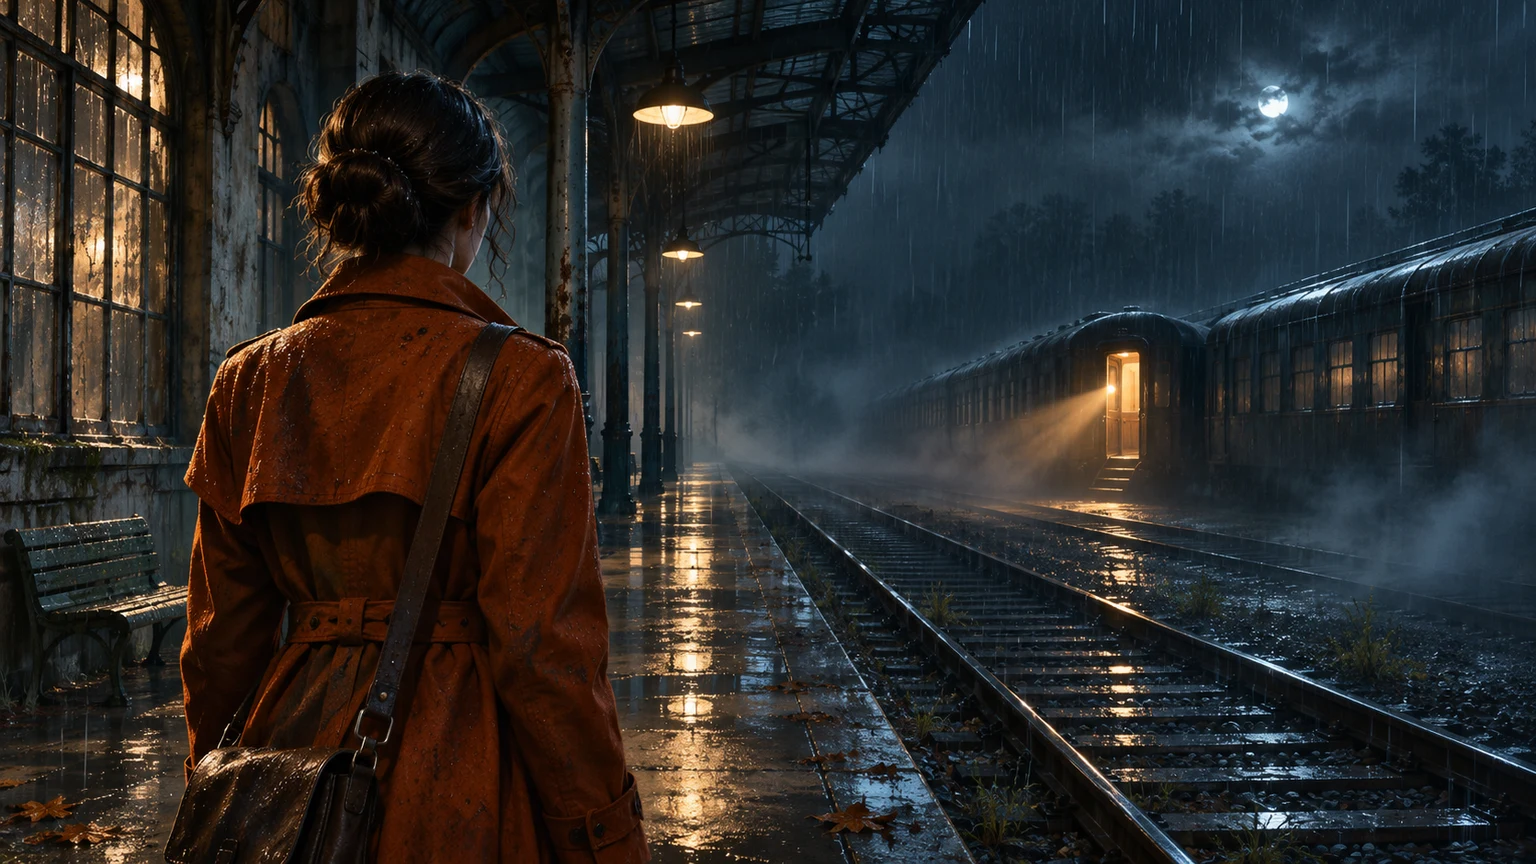
夜の廃駅を舞台にした静かなミステリーティーザー。錆びたオレンジ色のコートを着た成人の捜査官が、停車中の列車に暖かい光を見つける。無人の濡れたホームの広い画から始め、車両へ一歩近づくところで近景へカット。最後は明るい窓を一瞬横切る影を見せるが、顔は明かさない。抑制したカメラ、現実的な雨と反射、同じコートと車両の形状。静かな雨と遠い金属のきしみ。音楽、台詞、字幕、タイトルカードなし。
短いクリップは展開を減らす。長尺はショットごとに作る。
この方向性を試すデモが世界観と疑問をどう提示するかを見てください。提案プロンプトは、自分の物語を考えるための出発点です。
30秒のデモ・16:9。静かな港が異変の舞台を示し、最後まで脅威の正体を残します。
無人の港の下から何かが聞こえる海辺の町。不安を積み重ね、一つの不穏な手がかりを見せます。
抑制の利いた海辺のミステリーティーザー。灰色の霧に包まれた無人の港をゆっくり空撮。水中から低い脈動を聞いて足を止める成人の港湾作業員へカット。最後は潮に逆らう波紋で終え、発生源は見せない。自然な人体、落ち着いた色、明確なカット、静かな風と低い水中音。台詞、タイトル、文字なし。
15秒のデモ・16:9。広い風景で孤独を示し、近景でロボットの使命を身近にします。画角の変化に注目してください。
放棄された世界から信号を送ろうとする孤独なロボット。その努力を見せ、返事は明かしません。
放棄された惑星の古びたロボットを描くSFティーザー。日食の下、風の強い尾根を横切るところから始める。壊れたアンテナに到着し、琥珀色の灯りが点滅する近景へカット。応答が来る前に終える。ロボットの形状は一貫させ、金属は現実的に。目的のある動作、風と短い電子音。文字、カウント表示、ナレーションなし。
具体的な問題を見つけ、一つ変更して同じ瞬間を比較します。
はい。プロンプトは必須ですが参考画像は任意です。人物、場所、スタイルの参考を最大6枚追加できます。
1回の生成で、選んだモデルの長さに応じたクリップを作成します。長い予告編は複数のショットを生成し、編集ソフトでタイトルや音とともにつなげてください。
テキストと任意の参考画像に対応した連携モデルを選べます。長さはモデルによって異なります。音声生成は有効なので、必要な環境音、台詞、音楽をプロンプトで指定できます。
このツールはテキストと任意の画像から新しい映像を作ります。映画の分析や既存映像のハイライト自動抽出は行いません。
いいえ。ボタンは編集可能な入力を読み込むだけです。表示された料金で生成を送信するまで処理は始まりません。